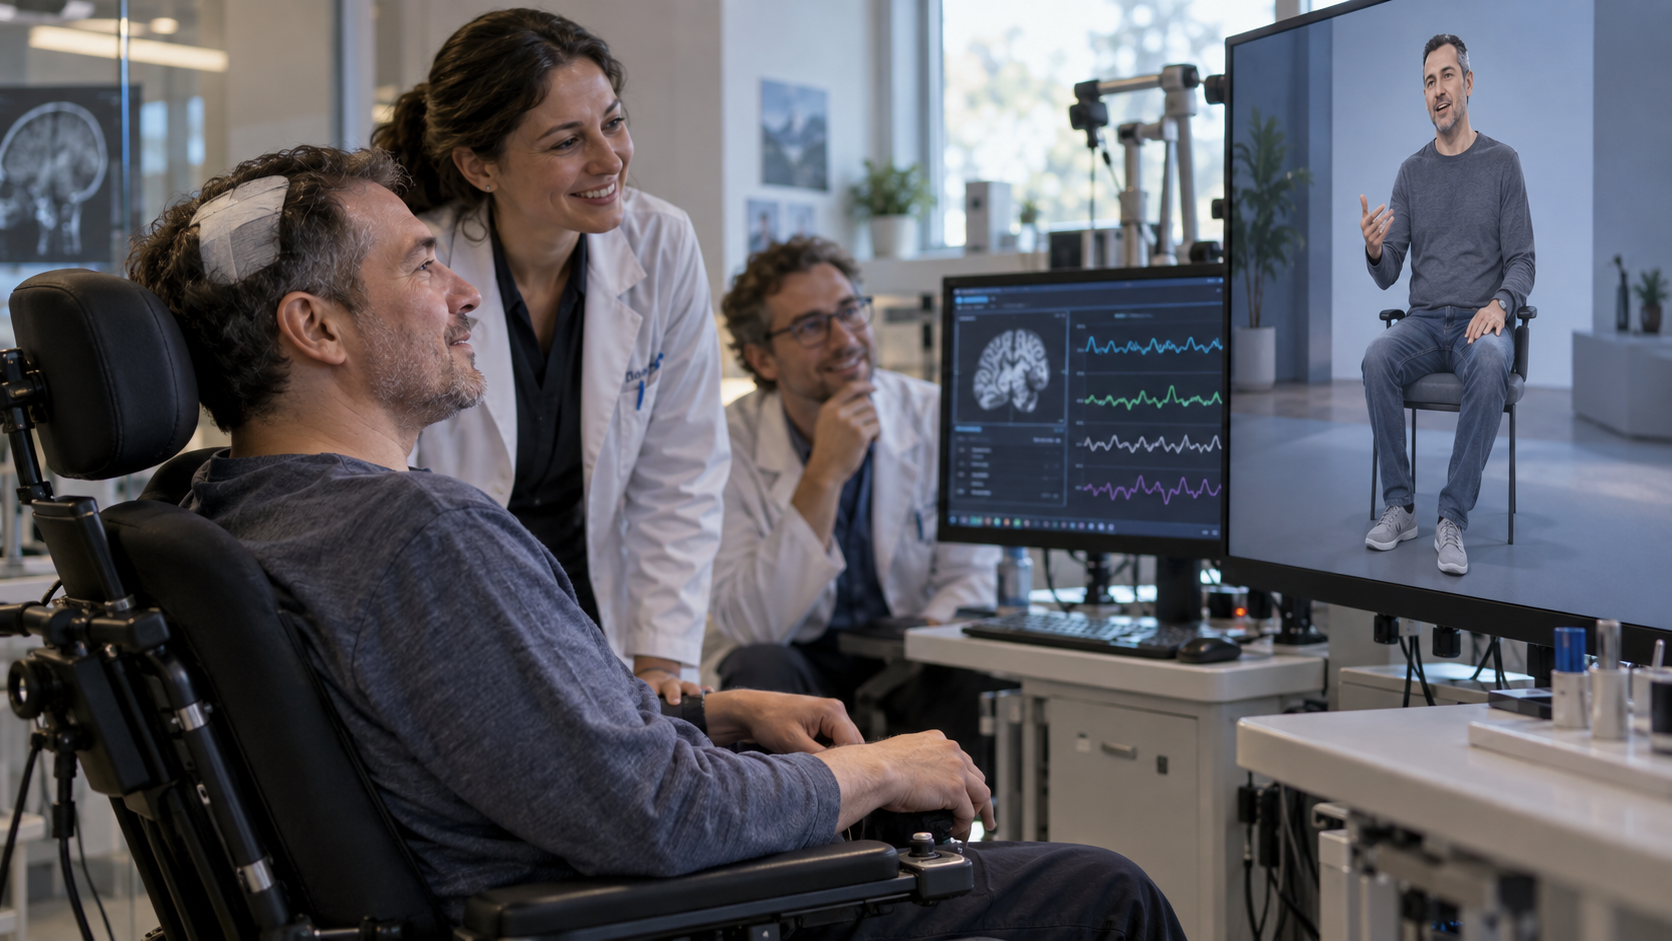
Когда мы разговариваем, одних слов почти никогда не бывает достаточно. Мы киваем, пожимаем плечами, машем рукой, показываем пальцем или усиливаем сказанное жестом. Для человека с тяжёлым параличом исчезновение этих движений означает потерю большой части привычного общения — даже если компьютер уже научился расшифровывать его попытки говорить.
Теперь американские исследователи впервые показали мозговой имплант, способный распознавать речь и жесты одновременно. Система считывает электрическую активность мозга, определяет, что человек пытается сказать и какое движение хочет выполнить, после чего выводит фразу на экран и заставляет персонального цифрового аватара сделать соответствующий жест.
Работа исследователей Калифорнийского университета в Сан-Франциско опубликована 14 сентября в журнале Nature Neuroscience. В эксперименте участвовали три человека с тяжёлым параличом, нарушениями движений и невозможностью нормально говорить.
Один имплант вместо нескольких систем
В мозг участников хирургически установили тонкую сетку из 253 электродов. Она располагалась на поверхности левого полушария над областями сенсомоторной коры, связанными с речью и движениями.
Когда человек пытался произнести фразу, поднять руку, кивнуть или выполнить другое движение, разные участки мозга создавали характерные электрические сигналы. Алгоритмы машинного обучения учились отличать эти сигналы друг от друга.
Сначала исследователи проверили движения и речь по отдельности. Но именно здесь и возникла главная сложность: в обычной жизни человек способен говорить и жестикулировать одновременно, а мозговые области, управляющие этими действиями, частично перекрываются.
Оказалось, что система, обученная только на отдельных движениях, хуже понимала человека, когда тот пытался соединить их. Поэтому учёные дали алгоритму примеры именно одновременной речи и жестов. После этого точность заметно выросла.
Человек говорит — аватар двигается
Для двух участников исследователи создали персонализированные цифровые аватары.
Человек получал задание, например попытаться произнести определённую фразу и одновременно представить или попытаться выполнить жест. Два алгоритма параллельно анализировали активность мозга: один распознавал речь, второй — движение.
Расшифрованная фраза появлялась на экране, а аватар практически сразу выполнял распознанный жест.
В одном из экспериментов использовались десять фраз и десять жестов, которые можно было комбинировать между собой в сотне вариантов. Среди движений были обычные элементы общения — например, кивки и движения рук.
Затем систему проверили уже в ситуации, больше похожей на настоящий разговор. Участникам задавали вопросы, а они отвечали с помощью речи, жеста или их сочетания.
У одного участника средняя точность составила 75% для речи и 85% для жестов. У другого в небольшой серии разговорных испытаний медианная точность достигла 100% для обоих типов сигналов. При этом сами авторы подчёркивают, что число таких испытаний пока было небольшим, поэтому эти показатели нельзя воспринимать как готовую характеристику будущего медицинского устройства.
Зачем нужны жесты, если компьютер уже понимает слова
За последние годы нейроинтерфейсы научились довольно хорошо расшифровывать попытки говорить у людей, потерявших речь. Но большинство таких систем решают только одну задачу.
Человек может получить возможность печатать словами или управлять синтезатором речи, однако само общение остаётся заметно беднее обычного разговора.
Кивок иногда заменяет целое предложение. Пожатие плечами показывает сомнение. Жест рукой может изменить эмоциональный смысл сказанной фразы.
Поэтому исследователи хотели вернуть не только передачу информации, но и хотя бы часть языка тела.
Как отмечает Nature, авторы называют эксперимент первым случаем, когда один имплант смог параллельно распознавать вербальную и невербальную коммуникацию и использовать их для управления цифровым аватаром в реальном времени.
До домашнего устройства ещё далеко
Пока это экспериментальная система, а не готовый медицинский прибор.
Участникам требовалась операция на мозге, а имплант был соединён проводами с внешним оборудованием. Словарь системы тоже пока очень мал: в основных испытаниях речь шла о нескольких заранее известных фразах и жестах.
Исследователям предстоит проверить технологию на большем числе людей и значительно расширить набор слов и движений.
Но следующий важный шаг уже готовится. Как сообщает Национальный институт здравоохранения США, команда Эдварда Чанга собирается испытать полностью имплантируемую беспроводную версию устройства, которая гораздо лучше подходит для длительного использования вне лаборатории.
Возможно, будущий цифровой аватар сможет не просто написать за человека фразу «я согласен», а одновременно кивнуть, улыбнуться или махнуть рукой — потому что именно это человек в тот момент действительно хотел сделать.